Automatyczna analiza tagów i sentymentu AI w odpowiedziach otwartych
Proces automatycznej analizy treści komentarzy w CustomerHero przekształca nieustrukturyzowane dane tekstowe w mierzalne insighty, niezbędne do podejmowania szybkich decyzji biznesowych. Dzięki wykorzystaniu zaawansowanych modeli języka naturalnego (NLP), system samodzielnie kategoryzuje wypowiedzi klientów i ocenia ich ładunek emocjonalny.
Jak działa proces analizy?
Działanie algorytmu składa się z trzech głównych etapów, które gwarantują wysoką jakość danych oraz pełne bezpieczeństwo informacji.
Krok 1: Definicja zakresu i filtrowanie danych wejściowych
Pierwszy etap przygotowuje surowe komentarze do efektywnego przetwarzania przez modele sztucznej inteligencji.
- Klucz kodowy (Tagi): System opiera się na dedykowanej liście kategorii tematycznych, kluczowych dla Twojego biznesu (np. „Obsługa klienta”, „Cena”, „Dostawa”, „Łatwość zakupów”). Stanowią one szkielet kategoryzacji.
- Redukcja szumu informacyjnego: Do analizy trafiają wyłącznie wypowiedzi merytoryczne. System automatycznie odrzuca komentarze krótsze niż 10 znaków (np. „OK”, „dzięki”), co znacząco podnosi jakość końcowych raportów.
Krok 2: Serwerowa anonimizacja danych (zgodność z RODO)
Zanim jakikolwiek tekst trafi do modeli językowych, przechodzi rygorystyczny proces anonimizacji po stronie serwerów CustomerHero/GetFeedback. Żadne dane wrażliwe klientów nie opuszczają naszej bezpiecznej infrastruktury.
- Dane strukturalne (Regex): Informacje o stałym formacie (PESEL, numery telefonów, adresy e-mail, numery kart, IBAN) są natychmiast wychwytywane i usuwane za pomocą wyrażeń regularnych.
- Dane kontekstowe (NER): Do rozpoznawania imion i nazwisk w języku polskim wykorzystujemy zaawansowaną technikę Named Entity Recognition, opartą na bibliotece Hugging Face Transformers.
- Placeholdery: Wszystkie usunięte dane osobowe są zastępowane bezpiecznymi znacznikami (np.
[imie],[adres email]), zachowując naturalny kontekst zdania dla sztucznej inteligencji.
Krok 3: Analiza sentymentu i tagowanie tematyczne
W pełni zanonimizowany tekst trafia do silnika AI, który analizuje go pod kątem merytorycznym i emocjonalnym.
- Dopasowanie tagów: Model AI czyta komentarz i precyzyjnie oznacza fragmenty tekstu odpowiadające tagom ze zdefiniowanego wcześniej klucza kodowego.
- Ocena sentymentu: Każdy przypisany tag otrzymuje konkretny wydźwięk: pozytywny, neutralny lub negatywny. Dzięki temu wiesz nie tylko, o czym piszą klienci, ale też czy dany obszar (np. czas dostawy) wywołuje ich frustrację, czy zadowolenie.
Jak analiza wygląda w panelu CustomerHero?
Wyniki pracy algorytmów są prezentowane w panelu w sposób przejrzysty i gotowy do natychmiastowej interpretacji:
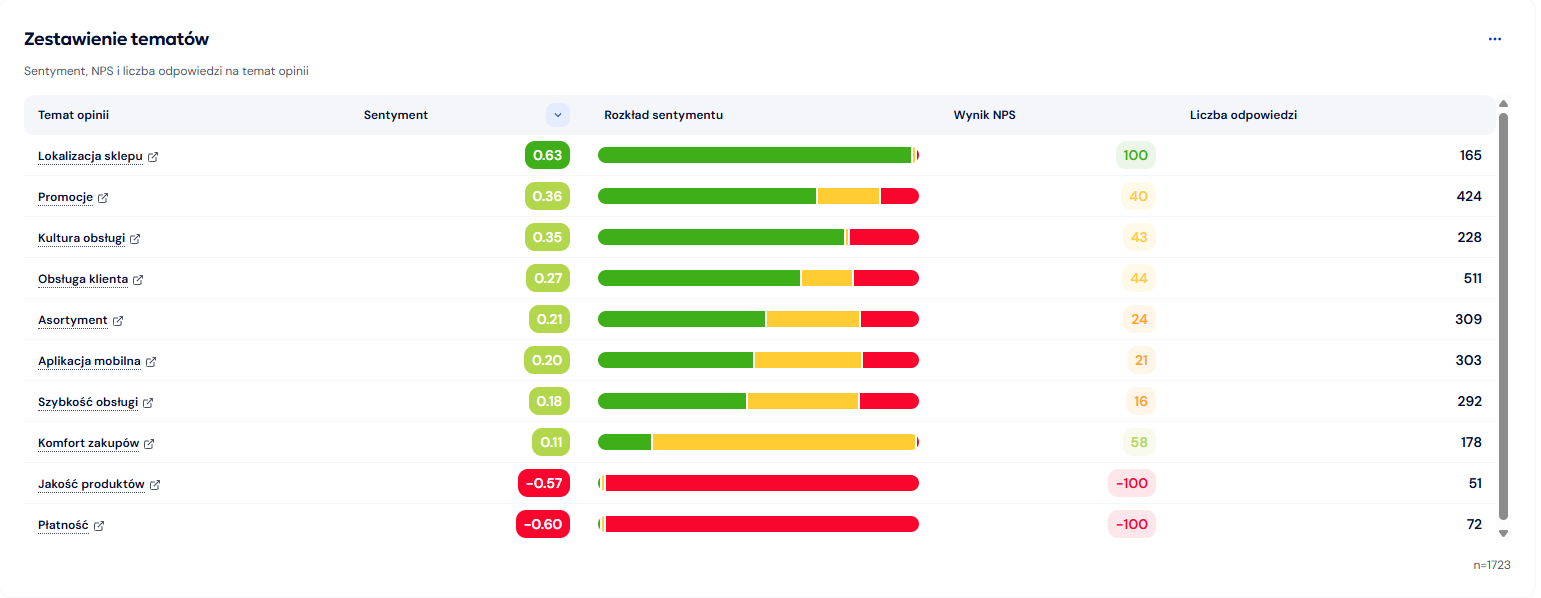
- Zagregowany widok analityczny: W sekcji raportów zobaczysz podsumowanie w formie wykresów. Tagi ułożone są według popularności, a każdy z nich posiada wskaźnik proporcji sentymentu (np. zielony pasek dla opinii pozytywnych i czerwony dla negatywnych w ramach tagu „Obsługa klienta”).
- Widok pojedynczej odpowiedzi: Przeglądając konkretny komentarz, zobaczysz podświetlone przez AI fragmenty tekstu. Obok podświetlenia wyświetla się przypisany tag oraz ikona/kolor oznaczający sentyment.
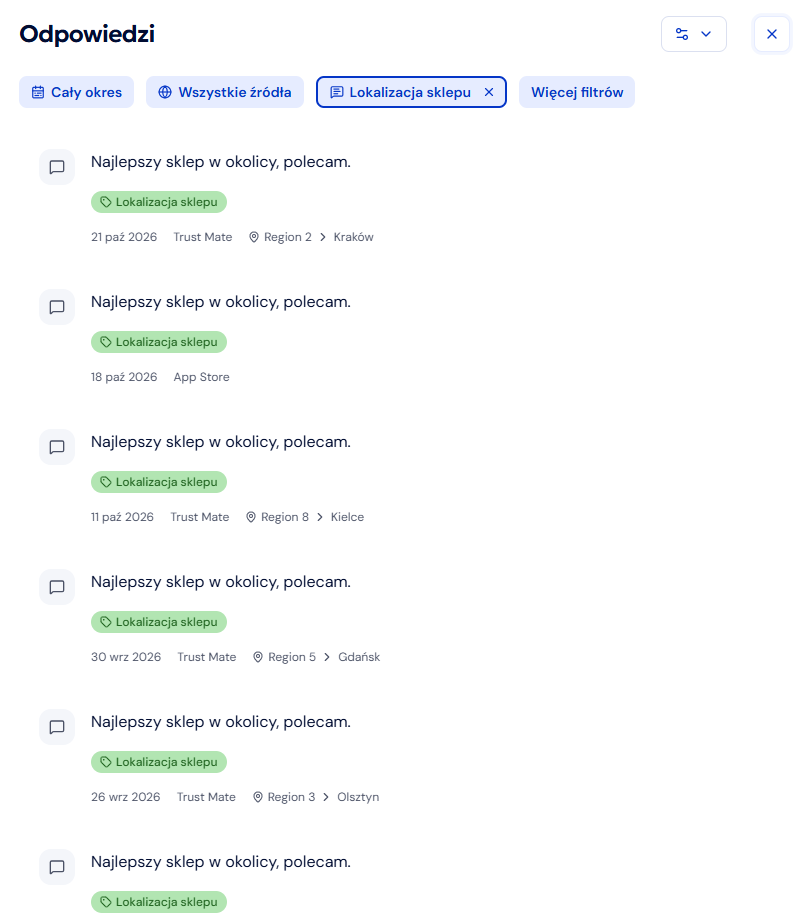
- Filtrowanie: Możesz łatwo zawęzić widok odpowiedzi, wybierając z listy konkretny tag i interesujący Cię sentyment (np. wyświetl tylko wypowiedzi negatywne dotyczące tagu „Cena”).
Elastyczność technologiczna modeli AI
Standardowo CustomerHero wykorzystuje zoptymalizowane modele OpenAI. Nasza architektura pozwala jednak na pełną elastyczność. W zależności od polityki bezpieczeństwa i strategii technologicznej Twojej firmy, możemy zintegrować system z innymi rozwiązaniami chmurowymi (np. Google Gemini Cloud) lub podłączyć prywatny, wewnętrzny model AI hostowany bezpośrednio w Twojej infrastrukturze.
Szczegółowy proces anonimizacji komentarzy
Jak wspomnieliśmy w Kroku 2 naszego procesu analizy, bezpieczeństwo danych i prywatność Twoich klientów to nasz najwyższy priorytet. Poniżej przygotowaliśmy szczegółowe, techniczne omówienie procesu anonimizacji. Dowiesz się z niego, jak dokładnie działa nasz autorski system, który dba o pełną zgodność z RODO (GDPR) jeszcze przed przekazaniem jakichkolwiek informacji do końcowej analizy AI.
Wprowadzenie i cel procesu
Głównym celem algorytmu jest anonimizacja danych osobowych zawartych w odpowiedziach tekstowych respondentów, zebranych w pytaniach otwartych ankiet. Proces ten ma kluczowe znaczenie dla zachowania prywatności oraz zgodności z regulacjami, a także jest niezbędnym krokiem przed wysłaniem anonimowych komentarzy do modeli językowych (LLM) w celu automatycznego tagowania, klasyfikacji i określania sentymentu.
Miejsce przetwarzania
Algorytm jest uruchamiany po stronie serwera (backend) w języku Python. Działa w trybie offline (asynchronicznym), na wydzielonej i bezpiecznej infrastrukturze firmy GetFeedback (CustomerHero), co zapewnia, że żadne dane klienta nie wychodzą poza naszą wewnętrzną infrastrukturę.
Zasada działania skryptu do anonimizacji
Zasada działania polega na precyzyjnym wyszukiwaniu wzorców danych osobowych w surowym tekście, a następnie ich usuwaniu i zastępowaniu odpowiednim, zdefiniowanym placeholderem (etykietą).
Metody wyszukiwania danych
Sposób identyfikacji danych różni się w zależności od typu poszukiwanej informacji:
| Typ Danej | Metoda Identyfikacji | Biblioteka/Narzędzie |
|---|---|---|
| Imię, Nazwisko | Rozpoznawanie Nazwanych Encji (NER) | Hugging Face Transformers (PyTorch) |
| E-mail, Numery (PESEL, Karta, IBAN, Telefon, Dowód) | Dopasowanie do zdefiniowanych Wyrażeń Regularnych (Regex) | Standardowe funkcje języka Python/PHP |
Detekcja Danych Osobistych za pomocą wyrażeń regularnych (Regex)
Wyszukiwanie ciągów cyfr i znaków o stałych lub łatwo definiowalnych formatach jest realizowane za pomocą precyzyjnych wyrażeń regularnych (regex). Jest to najprostsza i najbardziej niezawodna metoda dla danych strukturalnych.
| Typ Danej | Wyrażenie Regularne (Regex) | Placeholder |
|---|---|---|
| PESEL | /\b\d{11}\b/g | [pesel] |
| Nr Dowodu | /\b[a-zA-Z]{3}[-\s]?\d{6}\b/g | [nr dowodu] |
| Nr Rachunku (IBAN) | /\b(PL)?\d{2}(?:\s?\d{4}){6}\b/g | [nr rachunku bankowego] |
| Nr Karty Płatniczej | /\b(?:\d{4}[-\s]?){3}\d{4}\b/g | [nr karty] |
| Nr Telefonu | /\b(?:\+?48[\s]?)?(?:\d[\s]?){7,11}\b/g | [nr telefonu] |
| Adres E-mail | /[a-z0-9!#$%&'*+/=?^`{|}~-]+(?:\.[a-z0-9!#$%&'*+/=?^`{|}~-]+)@(?:[a-z0-9](?:[a-z0-9-][a-z0-9])?\.)+[a-z0-9](?:[a-z0-9-]*[a-z0-9])?/g | [e-mail] |
Detekcja Imion i Nazwisk za pomocą NER
Ze względu na niestrukturalizowany charakter imion i nazwisk (ich identyfikacja wymaga rozumienia kontekstu zdania), wykorzystywana jest zaawansowana technika uczenia maszynowego.
1. Rola Named Entity Recognition (NER)
NER (Named Entity Recognition) jest techniką Przetwarzania Języka Naturalnego (NLP), która automatycznie identyfikuje i klasyfikuje w tekście wyrażenia odnoszące się do rzeczywistych obiektów (zwanych encjami).
- Zastosowanie w procesie: Skrypt wykorzystuje model językowy (LLM) do oznaczenia fragmentów tekstu jako encje typu "Osoba" (np. Imię, Nazwisko, Stanowisko). Jest to jedyny sposób, który jest w stanie skutecznie analizować i rozumieć kontekst języka polskiego na wystarczająco wysokim poziomie precyzji.
2. Wykorzystanie Biblioteki Hugging Face Transformers
Do implementacji modelu NER wykorzystywana jest biblioteka Hugging Face Transformers (z silnikiem PyTorch lub TensorFlow).
- Transformers: Jest to wiodąca biblioteka open-source, która udostępnia tysiące wstępnie wytrenowanych modeli do zadań NLP. Użycie modelu z tej biblioteki (często są to modele BERT, RoBERTa lub podobne, wytrenowane na dużych korpusach języka polskiego) pozwala na osiągnięcie wysokiej dokładności w identyfikacji PII.
- Bezpieczeństwo: Biblioteka jest zainstalowana i uruchamiana na wewnętrznych serwerach GetFeedback, co jest kluczowe dla polityki bezpieczeństwa. Zapewnia to przetwarzanie danych wewnątrz kontrolowanej infrastruktury, eliminując ryzyko wycieku danych do zewnętrznych usług.
Zastąpienie danych placeholderami (Anonimizacja)
Po identyfikacji, oryginalna treść (np. imię i nazwisko lub numer telefonu) jest usuwana i zastępowana odpowiednią etykietą zastępczą, zgodnie z poniższą listą.
| Placeholder | Oryginalna Dana |
|---|---|
| [imie] | Imię (np. Anna) |
| [nazwisko] | Nazwisko (np. Nowak) |
| [imie i nazwisko] | Imię i Nazwisko (w przypadku wykrycia obu) |
| [adres email] | Adres e-mail |
| [nr telefonu] | Numer telefonu |
| [nr karty] | Numer karty płatniczej |
| [nr rachunku bankowego] | Numer rachunku (IBAN) |
| [pesel] | Numer PESEL |
| [nr dowodu] | Numer dowodu osobistego |
Przykład Wyniku:
- Tekst Oryginalny: "Proszę o kontakt na adres anna.nowak@firma.pl lub zadzwonić pod numer 123-456-789. Byłem w oddziale w Krakowie."
- Tekst Anonimowy: "Proszę o kontakt na adres [e-mail] lub zadzwonić pod numer [nr telefonu]. Byłem w oddziale w Krakowie."
Schemat potoku danych (Data Pipeline Flow)
- Dane Wejściowe: Odpowiedź tekstowa respondenta (surowy tekst) po stronie serwera GetFeedback.
- Krok 1: Identyfikacja Danych Strukturalnych (Regex):
- Uruchomienie skryptu z wyrażeniami regularnymi (Regex) w celu identyfikacji numerów (PESEL, Karta, IBAN, Telefon, Dowód) oraz adresów e-mail.
- Znalezione fragmenty tekstu są natychmiast usuwane i zastępowane odpowiednimi placeholderami (
[nr telefonu],[adres email], itd.).
- Krok 2: Identyfikacja Danych Kontekstowych (NER/LLM):
- Pozostały, częściowo anonimowy tekst jest przekazywany do lokalnie hostowanego modelu Hugging Face Transformers (NER).
- Model identyfikuje encje typu "Osoba" (Imiona, Nazwiska, Inicjały).
- Znalezione imiona/nazwiska są usuwane i zastępowane placeholderami (
[imie],[nazwisko]).
- Krok 3: Dane Wyjściowe (Tekst Anonimowy):
- W pełni anonimowy tekst jest zapisywany w bazie danych.
- Tekst jest gotowy do dalszego przetwarzania przez modele LLM (tagowanie, sentyment) lub do wyświetlania na panelach.